Dein KI-Problem ist nicht zu wenig Daten - es ist zu wenig geklärtes Wissen
Mehr Dokumente machen Deine KI nicht klüger, nur selbstbewusster im Irrtum. Warum das eigentliche Problem Klärung heisst - und wer haftet, wenn die gesprochene Zahl falsch war.
Ein Reflex begleitet fast jedes KI-Projekt im Mittelstand. Sind die Antworten schlecht, kippen wir mehr Dokumente ins System. Mehr Handbücher, mehr Reports, mehr Protokolle, mehr Mailverläufe.
Die Annahme: Mehr Information ergibt mehr Intelligenz.
Sie ist falsch. Mehr Dokumente machen Deine KI nicht klüger. Nur selbstbewusster im Irrtum. Die meisten Unternehmen haben kein Mengenproblem. Sie haben ein Klärungsproblem.
Information ist nicht Wissen
Die Maschine findet Muster, Ähnlichkeiten, Textstellen und wahrscheinliche Antworten.
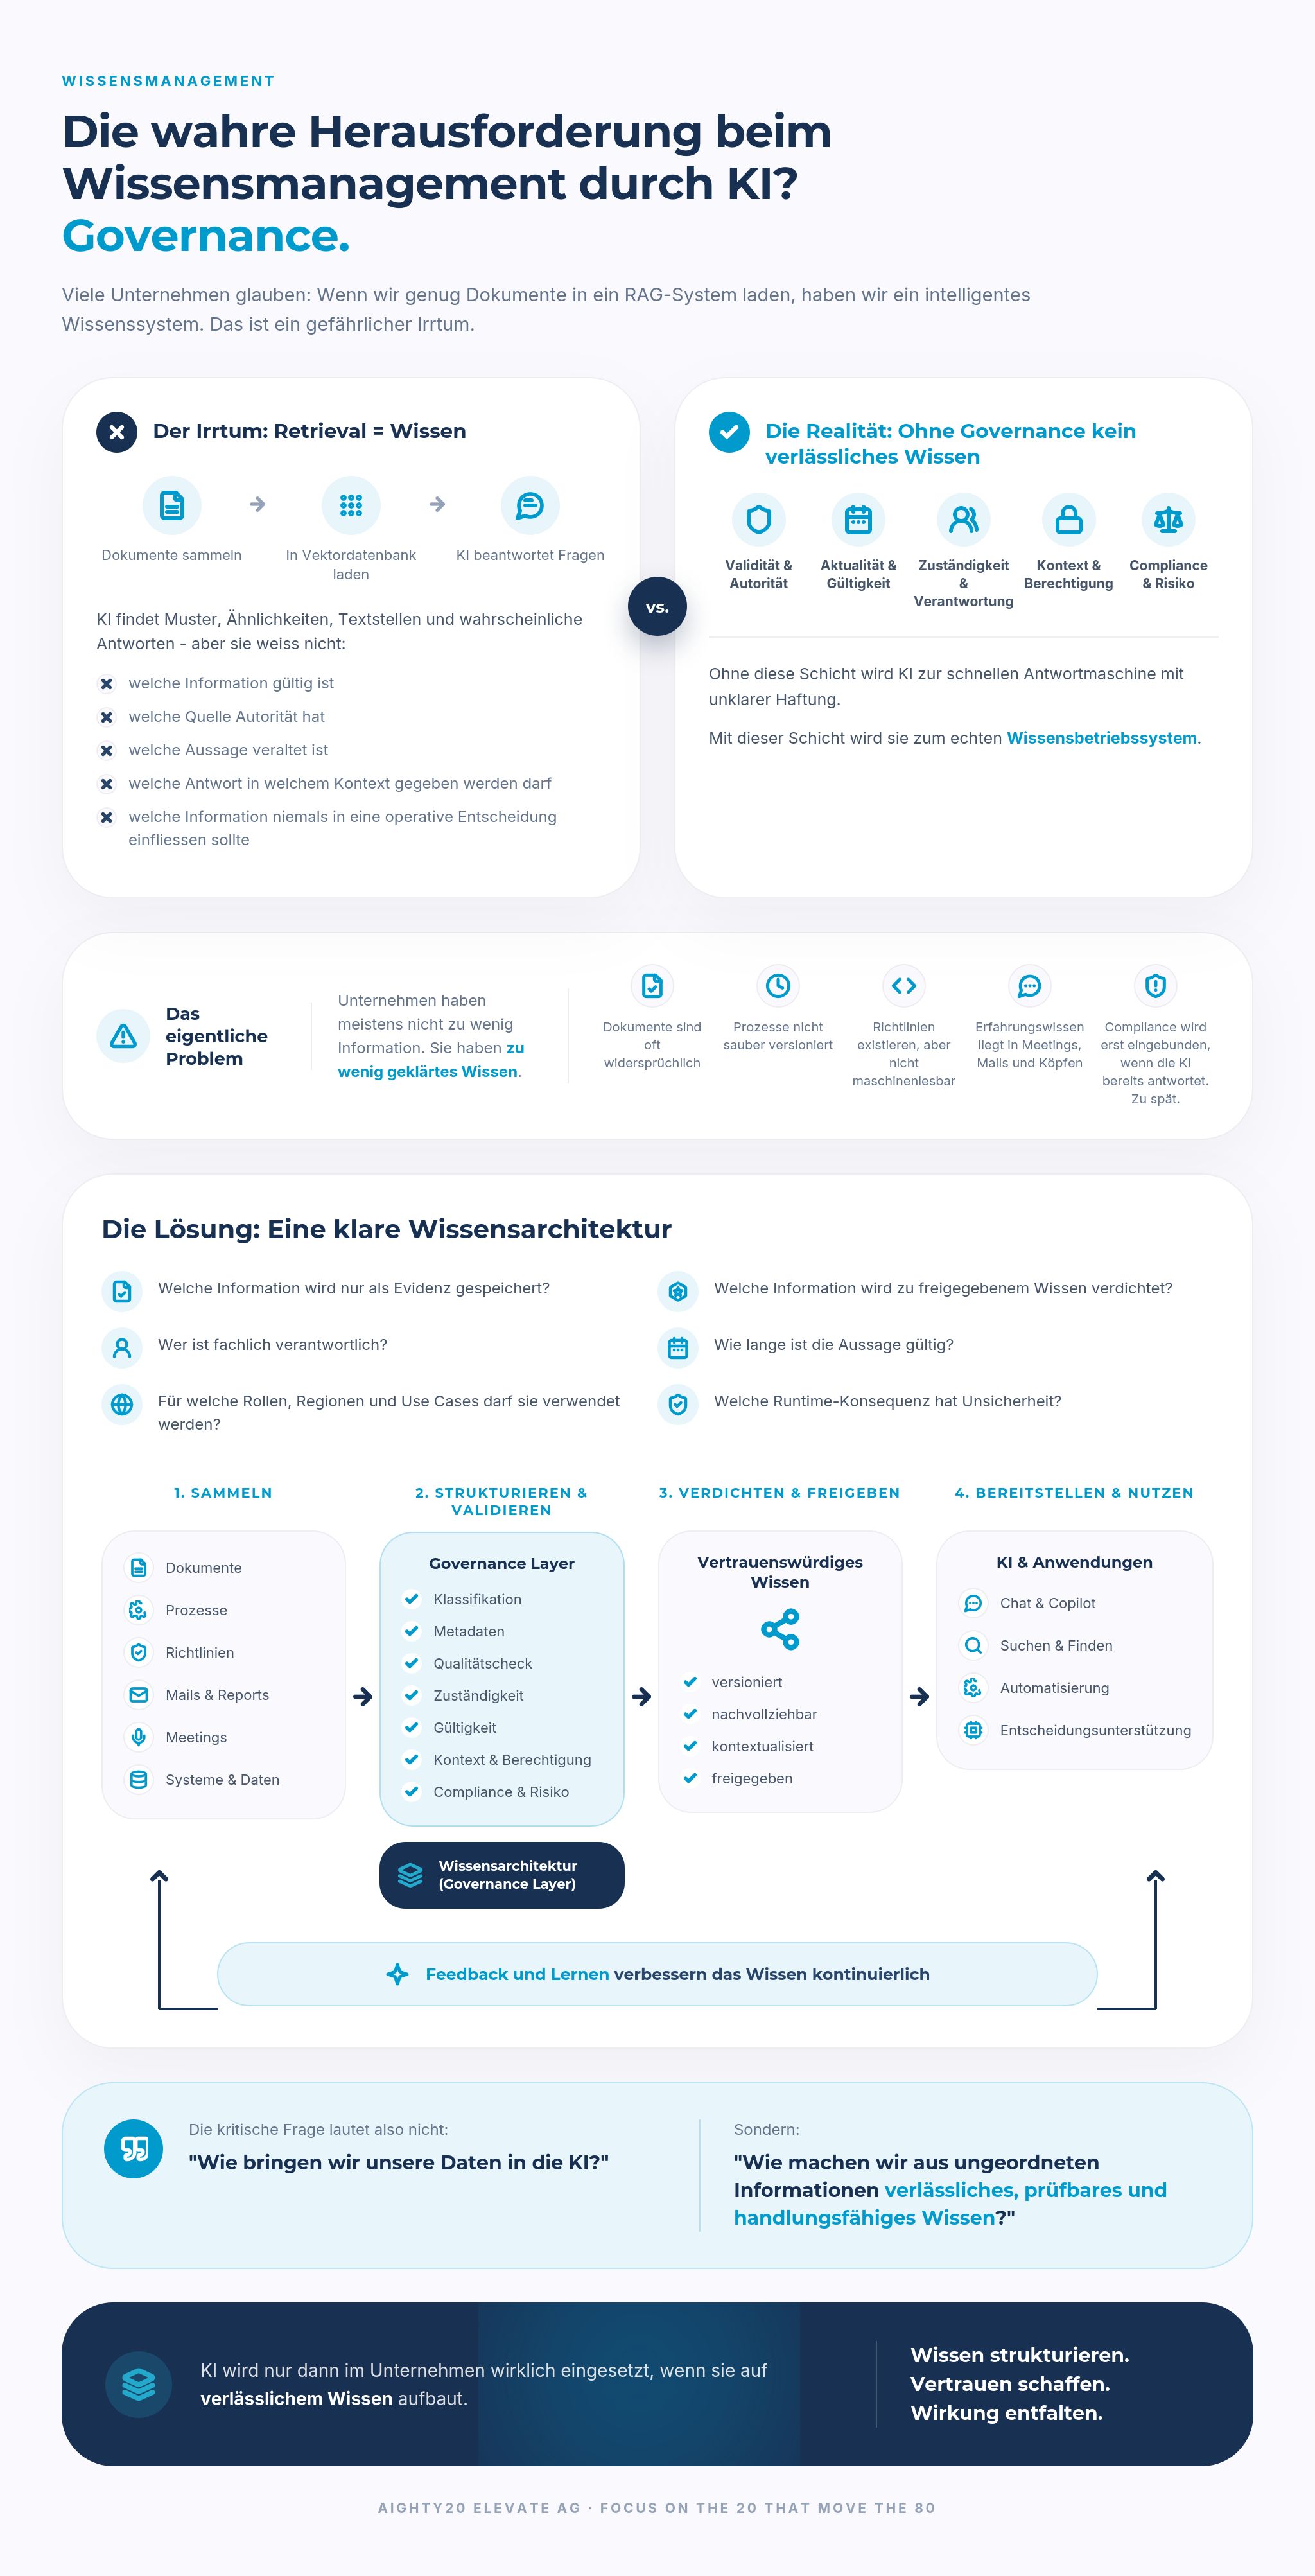
Was sie nicht weiss: welche Information gültig ist und welche überholt. Welche Quelle Autorität hat - der offizielle Prozess oder die Mail, in der jemand eine Ausnahme erlaubte. Wer fachlich zuständig ist und für die Aussage geradesteht. In welchem Kontext und für welche Rolle eine Antwort gegeben werden darf. Welche Information aus Compliance-Gründen nie in eine operative Entscheidung fliessen sollte.
Ein Stapel Dokumente beantwortet keine dieser Fragen. Er verschärft sie. Unternehmensdaten widersprechen sich. Prozesse sind selten versioniert. Richtlinien existieren, aber nicht maschinenlesbar. Das wertvollste Erfahrungswissen steckt in Meetings, Mails und Köpfen.
Lass die KI auf diesen Haufen los, und sie liefert schnelle Antworten mit unklarer Herkunft. Das ist keine Intelligenz. Das ist eine Antwortmaschine ohne Verantwortung.
Ein Beispiel, das jeder kennt. Zur Frage "Wie hoch ist unser Rabattspielraum bei Neukunden?" findet das System drei Quellen. Eine Pricing-Richtlinie von 2023. Eine aktuellere Folie aus einem Sales-Meeting. Eine Mail, in der ein Vertriebsleiter für einen Einzelfall 20 Prozent freigab.
Alle drei sind ähnlich zur Frage. RAG hat keinen Grund, die Mail nicht als Regel auszugeben. Sie steht ja im Index. Ein Mensch wüsste sofort, welche Quelle gilt. Das System weiss es nicht. Niemand hat ihm gesagt, was Autorität hat und was nur Evidenz ist.
Die Frage, die alles entscheidet: Wer haftet?
Das System antwortet auf "Wie hoch war unser Umsatz im zweiten Quartal?". Jemand handelt. Korrigiert eine Prognose. Gibt eine Investition frei. Nennt die Zahl im Gespräch mit der Bank.
Und die Zahl war falsch.
Wer haftet?
Bei einem Dashboard ist die Antwort klar. Definierte Kennzahl, definierte Quelle, jemand hat freigegeben. Bei einer KI, die aus einem Dokumentenhaufen eine plausible Zahl zusammensetzt, weiss es niemand genau.
Ohne eine Schicht, die festlegt, was gilt und wer zuständig ist, wird KI zur schnellen Antwortmaschine mit diffuser Haftung. Unter nDSG und DSGVO ist das kein theoretisches Risiko.
Was eine Governance-Schicht tatsächlich tut
Der fehlende Baustein ist kein grösserer Vektorindex. Es ist eine Wissensarchitektur - ein Governance Layer zwischen den rohen Informationen und der antwortenden KI. Seine Aufgabe ist nicht, mehr zu finden. Sondern zu klären.
Sammeln. Dokumente, Prozesse, Richtlinien, Mails, Meetings, Systemdaten.
Strukturieren und validieren. Klassifizieren. Mit Metadaten versehen. Qualität prüfen. Zuständigkeit zuweisen. Gültigkeit und Berechtigung festlegen. Compliance-Risiko markieren.
Verdichten und freigeben. Aus geprüftem Wissen entsteht ein vertrauenswürdiger, versionierter Stand. Was Evidenz ist, bleibt Evidenz. Was freigegeben ist, wird genutzt.
Bereitstellen. Erst jetzt greift die KI zu. Auf geklärtes Wissen, nicht auf einen Haufen.
Der Unterschied im Ergebnis ist fundamental. Ohne diese Schicht: eine Antwortmaschine mit unklarer Haftung. Mit ihr: ein System, dessen Antworten geprüft, belegbar und verantwortbar sind.
Diese Klärung ist kein Projekt. Sie ist eine Schleife. Jede Nutzung erzeugt Feedback - eine Korrektur, eine Rückfrage, ein "das stimmt so nicht". Genau das verbessert das geklärte Wissen weiter. Governance ist kein Aktenordner, der einmal gefüllt wird. Sie ist ein Prozess, der das System mit jeder Woche verlässlicher macht. Wer sie als statische Pflichtübung missversteht, baut eine Bremse statt eines Motors.
Wo wir stehen
Die meisten Anbieter verkaufen Dir die Antwortmaschine und überlassen Dir die Haftung. Wir halten das für die falsche Reihenfolge.
Aus unserer Partnerschaft mit Overmind kennen wir die Governance-Architektur, die Wissen klärt, bevor die KI antwortet. Im DACH-Kontext ist genau diese Klärung der Unterschied zwischen einem nützlichen Werkzeug und einem Compliance-Risiko mit Sprachausgabe.
Die kritische Frage lautet nicht "Wie bringen wir unsere Daten in die KI?". Sie lautet: Wie machen wir aus ungeordneten Informationen verlässliches, prüfbares Wissen? Die erste Frage löst ein technisches Problem. Die zweite löst Dein eigentliches.
nDSG und DSGVO verlangen den Nachweis, auf welcher Grundlage entschieden wurde. Eine KI, die ihre Quelle nicht kennt, ist nicht nur unpräzise. Sie ist ein dokumentiertes Risiko.
Governance ist damit keine Kür. Sie ist die Eintrittskarte für den regulierten Einsatz - der Unterschied zwischen "wir probieren mal KI" und "wir setzen KI dort ein, wo Geld und Haftung dranhängen".
Dein nächster Schritt
Bevor Du Wissen in eine KI gibst: wisse, wie geklärt es ist.
Unsere nDSG-Compliance-Asset-Suite - Checkliste, Reifegrad-Scoring, fertige Deliverables - liefert den ehrlichen Standortbericht. Wo ist Dein Wissen prüfbar? Wo ist es Haftungsmasse? Und was klärst Du, bevor eine KI im DACH-Raum darauf antwortet?
Links
Hier findest Du weitere Informationen
Unsere Haltung. Kein Bullshit.
Wir filtern das Rauschen. Hier liest Du unsere ungeschminkte Meinung zu KI, Skalierung und Effizienz. Keine leeren Buzzwords. Nur die 20 %, die wirklich einen Unterschied machen.
Fakten statt Vermutungen.
Vergiss Bauchgefühl. Nutze Daten. Wir liefern Dir die Werkzeuge, um KI-Potenziale nicht nur zu sehen, sondern zu berechnen und zu skalieren.
Bereit für das System statt Stückwerk?
Bring deinen Fokus auf das nächste Level.
Wir bündeln Strategie, Enabling und Technik zu einer Einheit. Für Resultate, die bleiben.
Fokus-Check vereinbaren.