Warum Voice AI sich endlich schnell genug anfühlt
Tiefe oder Tempo - dieser Zielkonflikt ist gerade gestorben. Fast Talker vorne, Deep Thinker hinten, Policy Gate dazwischen. Und der ehrliche Vorbehalt: Tempo ohne Korrektheit ist beschleunigter Irrtum.
Voice AI ist nicht neu. Sprachassistenten gibt es seit über einem Jahrzehnt. Die Erfahrung ist überall dieselbe: nett für einen Timer, unbrauchbar für alles, was zählt.
Der Grund war ein Zielkonflikt, der unlösbar schien. Er ist gerade gestorben. Und das erklärt, warum Voice ausgerechnet jetzt vom Spielzeug zum Werkzeug wird.
Der alte Zielkonflikt: Tiefe oder Tempo
Eine gute Antwort auf eine Geschäftsfrage benötigt Tiefe. Die richtige Datenquelle finden. Sauber filtern. Kontext berücksichtigen. Über Systeme hinweg recherchieren. Das kostet Sekunden.
Ein Gespräch verträgt keine Sekunden. Drei Sekunden Stille sind unangenehm. Bei fünf glaubst Du, die Verbindung sei tot. Sprache lebt von Sofortigkeit.
Tiefe Recherche und niedrige Latenz schlossen sich aus. Entweder kam die Antwort schnell und blieb oberflächlich. Oder sie wurde gründlich, und das Gespräch brach unter dem Warten zusammen.
Frühe Sprachsysteme fühlten sich deshalb dumm an oder zäh. Beides ist für den Betrieb unbrauchbar.
Die Architektur, die den Konflikt auflöst
Der Durchbruch ist keine schnellere Maschine. Es ist eine andere Aufteilung der Arbeit.
Statt ein System zu zwingen, gleichzeitig schnell und tief zu sein, teilt die moderne Voice-Runtime die Aufgabe auf.
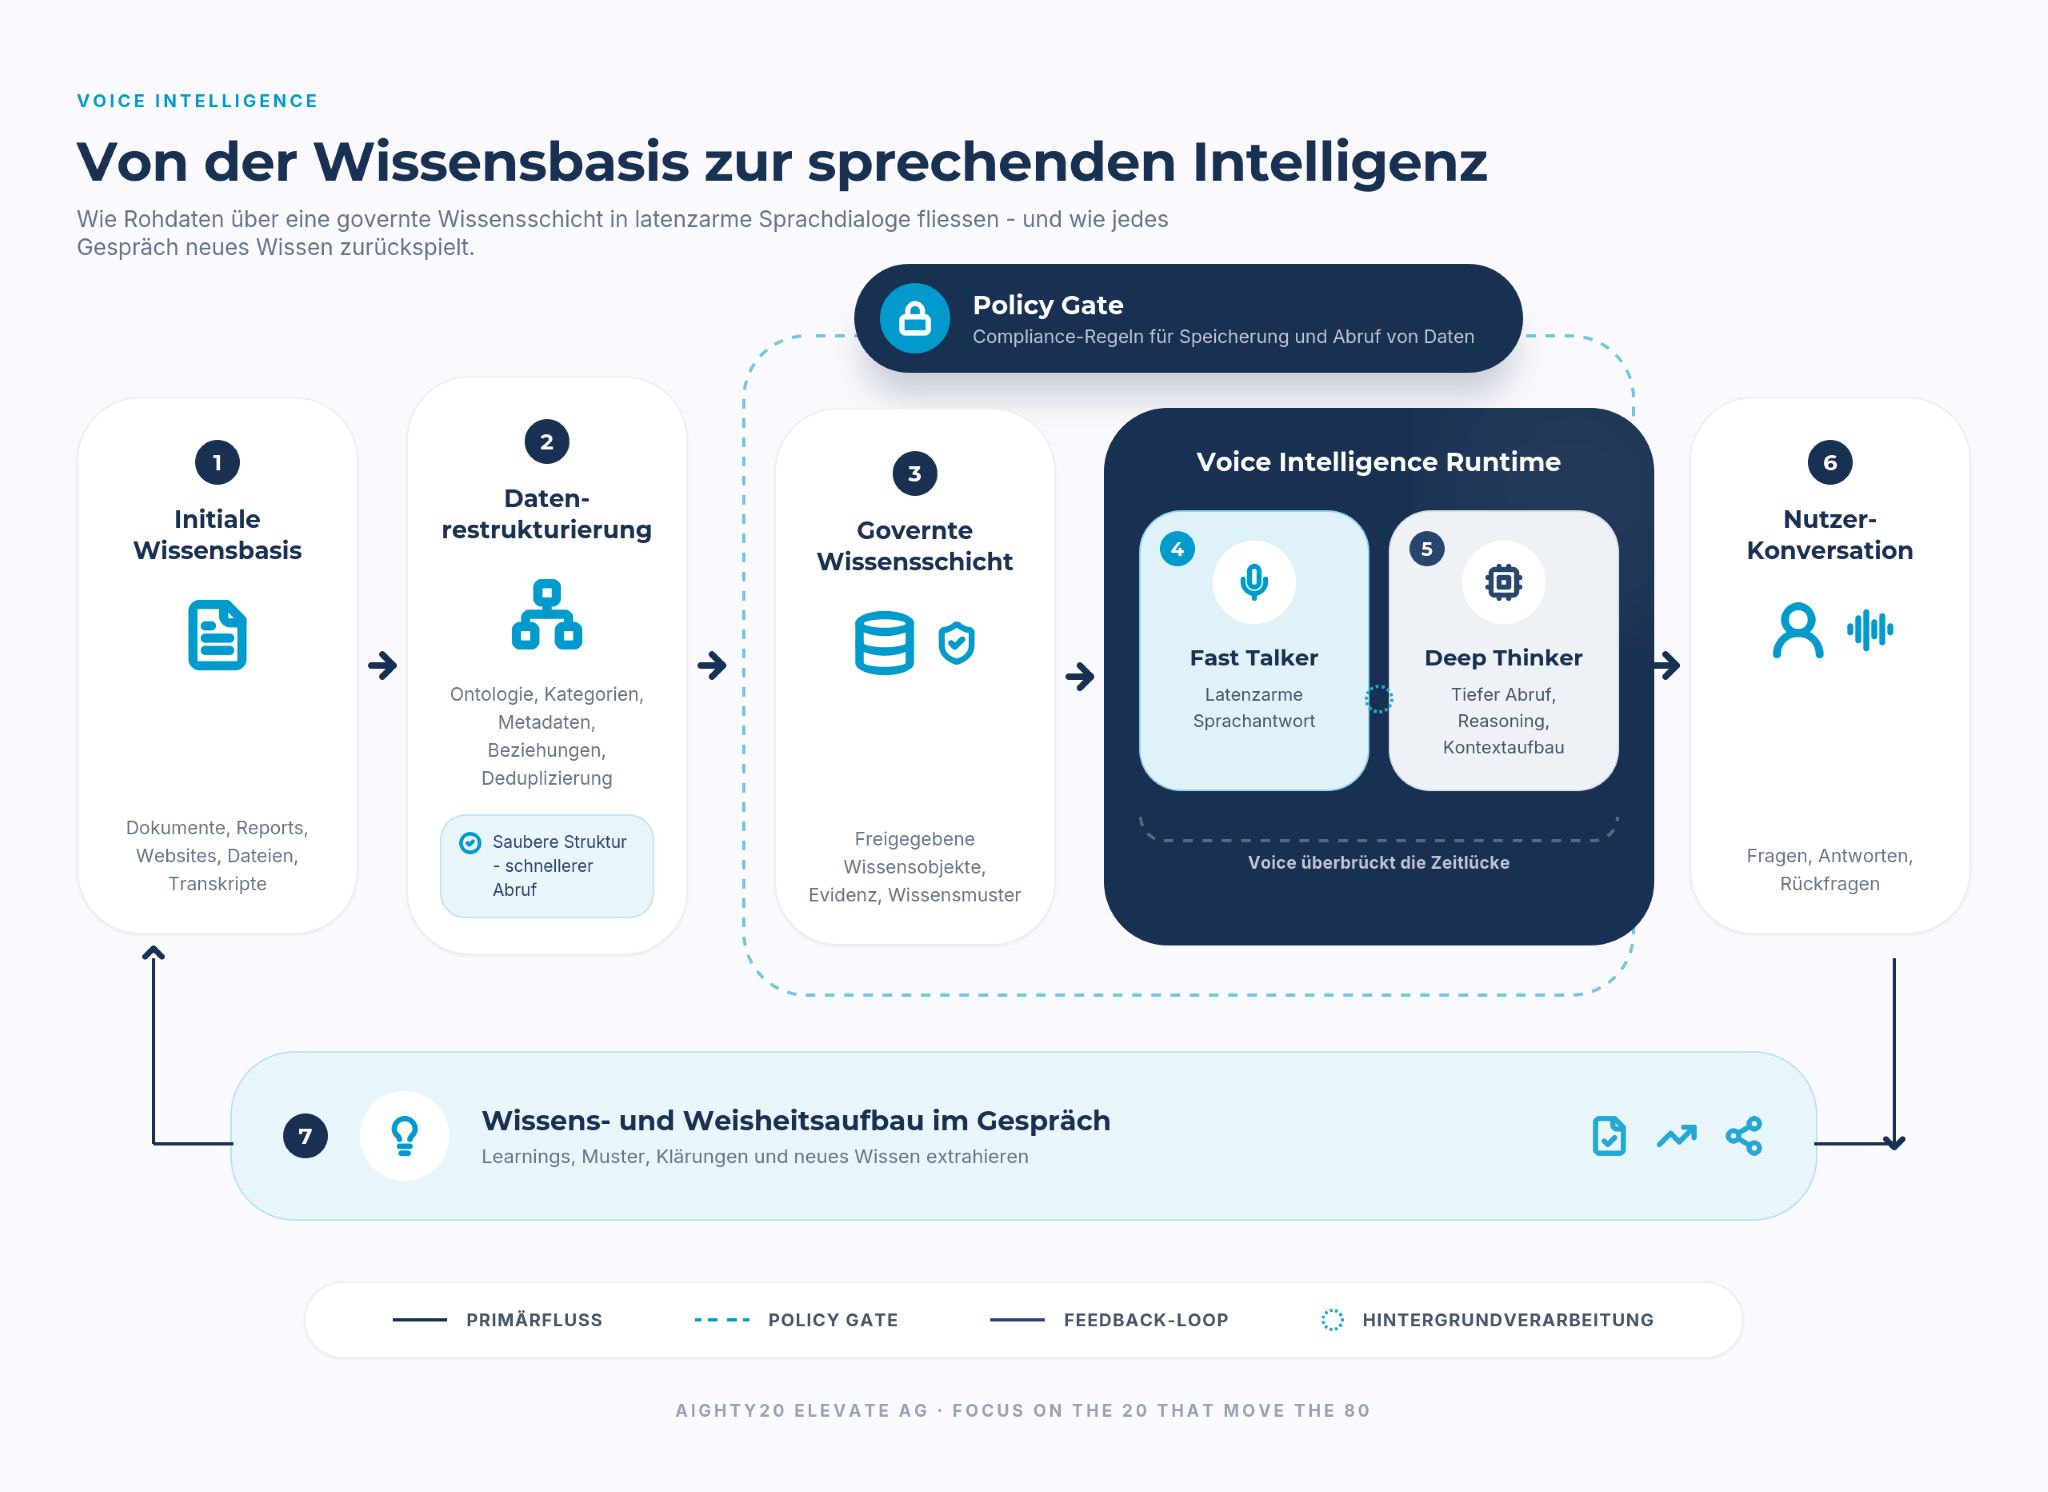
Der Fast Talker sitzt vorne. Optimiert auf niedrige Latenz. Er hält das Gespräch am Laufen, bestätigt die Frage, liefert sofort, was klar ist. Er überbrückt die Wartezeit so, wie ein Mensch es täte - der ja auch "Moment, ich schaue kurz nach" sagt, statt stumm dazusitzen.
Der Deep Thinker arbeitet dahinter. Optimiert auf Gründlichkeit. Tiefes Reasoning, echte Datenabfrage, Kontext über Systeme hinweg. Er nimmt sich die Zeit, die eine belastbare Antwort braucht.
Dazwischen sitzt das Policy Gate. Es setzt durch, welche Daten gespeichert und abgerufen werden dürfen. Die Bequemlichkeit vorne hebelt die Berechtigungen hinten nicht aus.
Overmind beschreibt das Ergebnis treffend: Voice überbrückt die Zeitlücke. Die Stimme füllt genau die Sekunden, in denen im Hintergrund die Arbeit läuft.
Konkret: Du stellst die Frage. In Sekundenbruchteilen bestätigt der Fast Talker und beginnt mit dem, was klar ist. In den zwei, drei Sekunden, die der Deep Thinker braucht, entsteht keine tote Stille, sondern Gesprächsfluss. So wie ein guter Mitarbeiter sagt: "Schau ich kurz nach, das war letztes Quartal etwas tiefer" - während er die Zahl heraussucht.
Die wahrgenommene Wartezeit sinkt dramatisch. Die echte Rechenzeit bleibt dieselbe. Genau dieses Gefühl - die Maschine lässt mich nicht hängen - entscheidet, ob Menschen ein Sprachsystem nutzen oder nach drei Versuchen aufgeben.
Warum das den Unterschied macht
"Wie hoch war unser Umsatz im zweiten Quartal?"
Eine ehrliche Antwort erfordert eine echte, gefilterte Abfrage gegen Dein BI-System. Kein vorgekautes Dokumentschnipsel. Der aktuelle Stand, sauber nach Mandant, Zeitraum und Währung geschnitten.
Das dauert. Früher hiess das: entweder sofort eine oberflächliche Schätzung aus einem alten Report. Oder so lange warten auf die exakte Zahl, dass die Sprachschnittstelle ihren einzigen Vorteil verlor.
Mit Fast Talker und Deep Thinker bekommst Du beides. Flüssiges Gespräch vorne. Belastbare Zahl hinten. Erst dadurch wird Voice betriebstauglich. Vorher war es eine Demo, die an der eigenen Latenz erstickte.
Der ehrliche Vorbehalt
Damit das trägt, müssen die ersten drei Teile dieser Serie sitzen.
Der Fast Talker überbrückt nur dann sinnvoll, wenn der Deep Thinker dahinter auf echte Daten und geklärtes Wissen zugreift. Eine elegante Runtime über einem RAG-Haufen ohne Governance liefert Dir eine plausible falsche Antwort - nur schneller.
Die Architektur löst das Tempo-Problem. Sie ersetzt nicht die saubere Datenbasis.
Tempo ohne Korrektheit ist kein Fortschritt. Es ist beschleunigter Irrtum. Schnell wird erst dann zum Wert, wenn richtig gesichert ist. In dieser Reihenfolge.
Wo wir stehen
Wir finden diese Architektur überzeugend. Das sagen wir auch so. Ein Selbstzweck ist sie nicht.
Ob sich der Aufwand lohnt, hängt davon ab, wie viele Deiner wiederkehrenden Fragen schnell genug und korrekt genug beantwortet werden müssen, um eine solche Runtime zu rechtfertigen.
Aus unserer Partnerschaft mit Overmind kennen wir die Technik im Detail. Unsere Aufgabe ist die nüchterne Einordnung. Wo ist Dein Setup nahe genug an einer betriebstauglichen Runtime - und wo fehlt das Fundament?
Dein nächster Schritt
Die relevante Frage ist nicht, wie beeindruckend die Architektur ist. Sondern wie weit Dein Stack von einer betriebstauglichen Voice-Runtime entfernt ist.
Unser Voice-AI-Readiness-Check bewertet genau diese Reife - Datenanbindung, Governance, Latenzanforderungen. Und zeigt Dir, was zwischen heute und einer Stimme steht, der man im Tagesgeschäft vertraut.
Links
Hier findest Du weitere Informationen
Unsere Haltung. Kein Bullshit.
Wir filtern das Rauschen. Hier liest Du unsere ungeschminkte Meinung zu KI, Skalierung und Effizienz. Keine leeren Buzzwords. Nur die 20 %, die wirklich einen Unterschied machen.
Fakten statt Vermutungen.
Vergiss Bauchgefühl. Nutze Daten. Wir liefern Dir die Werkzeuge, um KI-Potenziale nicht nur zu sehen, sondern zu berechnen und zu skalieren.
Bereit für das System statt Stückwerk?
Bring deinen Fokus auf das nächste Level.
Wir bündeln Strategie, Enabling und Technik zu einer Einheit. Für Resultate, die bleiben.
Fokus-Check vereinbaren.